最近クローラ+スクレイピングの勉強をしている。Web周りはこれまで不勉強だったものだから、非常に苦労している。種々のサイトを見ていると、サイトも色々だなぁと一サイトの管理人として思う。まぁWordPressをテンプレートそのまんまで使っているだけだが、それだけにこのサイトは扱いやすいだろうなと思う。
とはいえ世の中扱いづらいサイトのほうが多いわけで、学ぶべきことは多い。ということで、とりあえずGoogle検索からしてみる。
やりたいこと
自動でGoogle検索で一番最初にヒットしたサイトにアクセスしたい。
調べたところ、python + selenium + PhantomJS がよくあるみたいだ。
`pip install selenium
 brew install phantomjs`
seleniumはブラウザを操作できるソフトで、Chromeとかもスクリプトで自動操作できるようだ。が、ここではPhantomJSなるものを使う。PhantomJSは画面がなくても使えるヘッドレスブラウザというやつで、コマンドラインとの相性が良い。レンダリングエンジンはWebKit。JavaScriptも動くので、モダンなサイトでも使える。
ただ最近はChromeがヘッドレスモードを搭載したようで、それを受けてPhantomJSのメンテナーさんが降りたらしい。今後はそちらを使っていくべきか。まぁでも、とりあえず参考にした書籍がPhantomJSを使っていたので、そのとおりにやってみる。
ソースコード
このサイト名を検索して、トップ画像を撮影してみる。2秒待っているのは、表示のため。
`import time
 from selenium import webdriver
 from selenium.webdriver.common.keys import Keys

 wait_time = 2

 class WebScrape:
     def __init__(self):
         self._driver = webdriver.PhantomJS()
         self._driver.set_window_size(800,640)

     def screenshot(self, url):
         self._navigate(url)
         output = 'screenshot.png'
         self._driver.save_screenshot(output)

     def _navigate(self, url):
         self._driver.get(url)
         time.sleep(wait_time)

 class GoogleSearch(WebScrape):
     def __init__(self):
         super().__init__()

     def search(self, s):
         self._navigate('https://www.google.co.jp/')
         # check
         assert s in driver.title
         # search
         input_element = self._driver.find_element_by_name('q')
         input_element.send_keys(s)
         input_element.send_keys(Keys.RETURN)
         time.sleep(wait_time)
         # output
         results = []
         [results.append(a.get_attribute('href')) for a in self._driver.find_elements_by_css_selector('h3 > a')]
         return results


 if __name__ == '__main__':
     gs = GoogleSearch()
     sites = gs.search('或る阿呆の記')
     ws = WebScrape()
     ws.screenshot(sites[0])
 `
画像を確認して、ちゃんと撮影されていることを確認。
ちなみに画面の遷移は.get(url)ではなく.navigate().to(url)でもいけるようだが、意味はそう変わらないらしい(参考「起動したWebDriverにただページ遷移をさせたい - Qiita」)。
[caption id=“attachment_6244” align=“aligncenter” width=“362”]
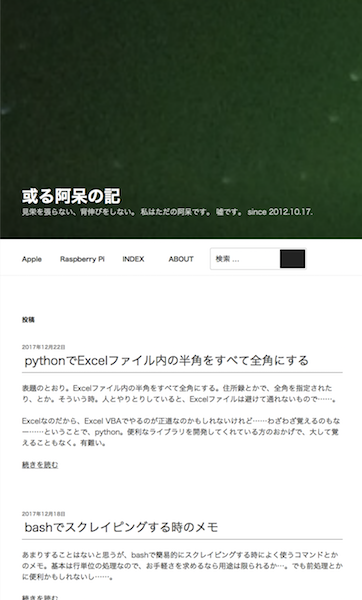
スクリーンショットの一部[/caption]
もうちょっとちゃんと使っていきたい。
ところで、Google検索自体にはAPIが用意されている(「Custom Search JSON/Atom API | Custom Search | Google Developers」)。あまり評判芳しくないようだが、本格的にGoogle検索を扱うのであればこのAPIを利用すべきなのだろう。ロボットで色々やりすぎると最悪Googleからbanされてしまうようで、たいへん恐ろしい。
参考
参考にさせていただきました。
特にこの書籍「Python クローリング&スクレイピング」はたいへん勉強になりました。本記事はこの本の5.6節の内容にあたります。良い本です。
コメント
コメントは承認後に表示されます。
まだコメントはありません。
コメントを書く