そんなもんモノによるやろとしか言えないわけですが、参考までに…。
環境
- LLM: qwen3.8-flash-next
- サーバ: GMKtec EVO-X2 (ミニPC)
- Ryzen AI Max+395
- 128GB RAM
- Windows 11
- LM Studio 0.4.25
- クライアント: M2 Pro Mac mini + VSCode + Cline
- 対象: Go + Next.js のセルフホスト型Webアプリケーション
LLM的なスペックでいえば、ユニファイドメモリ128GBのっけたRyzenなミニPCで、Vulkanで実行、という感じです。これが庶民にできる精一杯なんや……と思っていましたが今はこの構成マジで60万してて死にました。30万のときに10台くらい買っておけばよかった。もう世界はおしまいです。
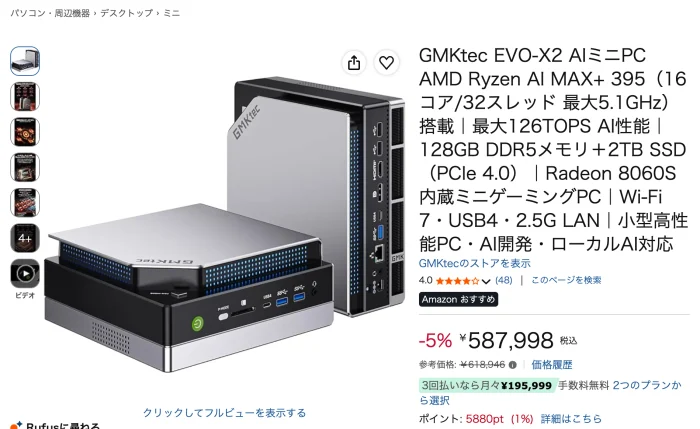
狂ってると思った。
改修内容
何かと言うと、私が趣味でやっているAIイラスト作成支援アプリの微改修です。Characterを登録する際に、いつも同じ情報があるため(わかる人向けに言うとmasterpieceなどクオリティ系やネガティブプロンプト)、それらをテンプレートとしていました。で、そのテンプレート自体を複製したい、というものです。
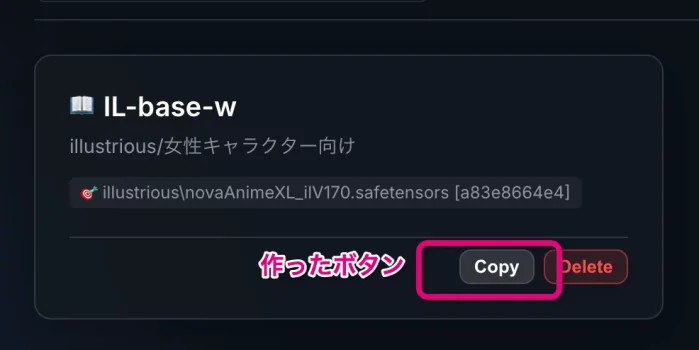
具体的には以下の画面改修です。
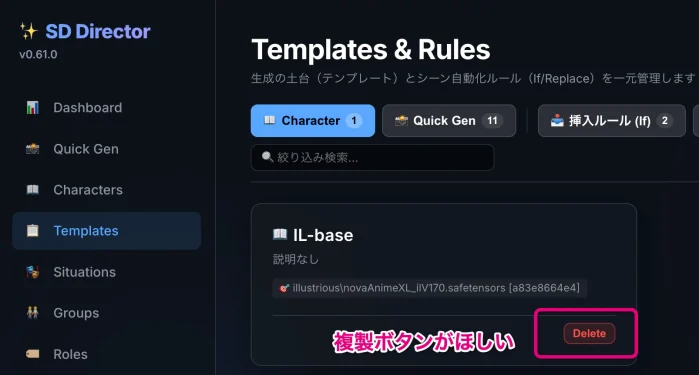
ここに複製ボタンを追加するだけです。複製する内容は具体的には以下のように、説明文であるとか、基本的な数値設定や、定型句となるプロンプト群です。
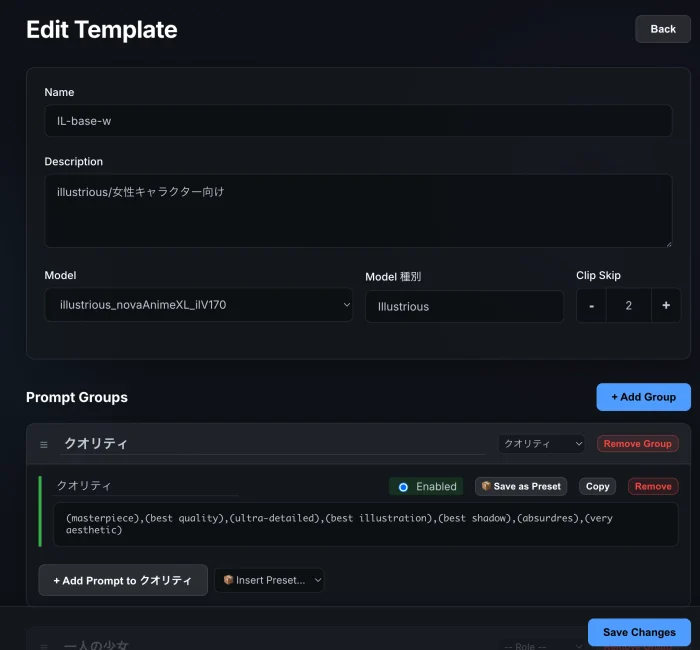
こいつをコピーする機能がほしいわけです。これはまぁ出来そうというか、出来てほしい感じがしますよね。
それでまぁ、細かく指示してもよかったけれど、ここはあえてふわっとした指示にします。
Templatesにおいて、Character用のテンプレートの複製を追加する。
Codexあたりならこれでまったく問題なく、投げたら数分で完全に完了すると思います。さてローカルLLMだとどうなるか……。
結果、2時間かけて完了です。2時間ノンストップで動き続けたんだから凄いといえば凄いんだけど、まぁまぁかかった感じですね。
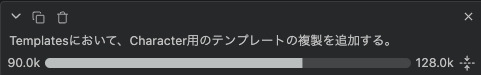
oh…90.0k…。でもちゃんと機能はできていました。コードもそんな変なことはなかった…ように思う。
ローカルLLMだとさすがにもうちょっと人間側が指示を明確にしたほうが良さそうな感じはしました。
しかし正直、AntigravityのGemini 3.8 Flashよりもなんだかちゃんとしている気がする……。いやさすがにそんなはずはないか…?まぁもうちょっとみていかないとけませんが。
唸れミニPC
しかし、マジで2時間ずっと唸っていましたね。これは電気代を考えたときにどうなんだろうか。多分DeepSeekのAPIで20円くらいの改修だったと思うんですよね。まぁ最大電力が230Wなんだからフルパワーでも0.46kWh、1kWh 30円なら13.8円、LLMなら常にフルパワーではないはずだし、計算上はAPIよりは安いとは言える。まぁちょっとどっかで消費電力は計測しよう。
でも安いといっても、本体が60万円するようではちょっともうペイしないですね。30万円でもペイはしないのに。しかし、検閲やら情報統制やら嫌な動きが加速していることもあり、今後は本当にローカルLLMに最終的に頼らざるを得ない世界線になるような気はしています。使えそうなときには積極的に使って感触をつかんでいきたいところです。
AI PCが高すぎる問題も、これはAIバブルが弾けた段階で、投げ売りのターンは来るんじゃないかなぁ…あるいはもっと軽量なモデルでコーディング限定なら頑張れるものが出てくるか。Qwen3.8-Flash-Nextローカル実行環境「Strata」更新。旧世代GeForceやArcに一筋の光 - PC Watchとか注目ですね。まぁとにかく、世の趨勢に負けず抵抗していきたいところです。
<関連記事>



コメント