DeepSeek V4.1 Flashで従量課金を始めたところ、コーディングにかかる費用が可視化され、oh…となっておりました。「この改修に20円か…」と思うと、まぁ安いといえば安いんですが、別に儲かっているわけでもない個人開発者としては真顔になります。
ということで、今一度試すぞローカルLLM…!Qwen3.8-Flash-Nextが話題になっていたことを思い出し、数時間かけてダウンロード。頼むぞ…( ・`ω・´)
環境
- GMKtec EVO-X2
- Ryzen AI Max+395
- 128GB RAM
- LM Studio v0.4.24
qwen3.8-flash-next:Q4_K_M- 95.43GB(^_^;)
早速実行していくかい?
テストがてら、開発中のアプリで一つ簡単な改修をすることにしました。D-Shelf(仮)という、メディア管理ツールを制作しているのですが、これで余計な機能があったので削除しようとしています。以下の画面のうち、「一覧のすべてを読了にするボタン」、これが不要です。
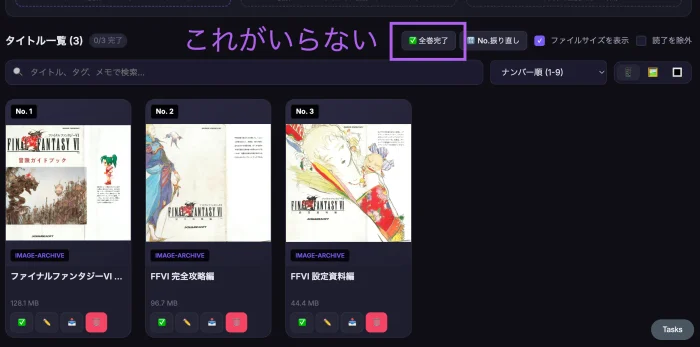
このボタンを削除するだけです。これはまぁ、出来てほしいなって感じですね。
プロンプトと言えるほどでもないプロンプト。
Work詳細(タイトル一覧)にある全巻読了の機能は、これは不要であるので、削除する。
実行後、EVO-X2が唸りをあげ始めます。今度消費電力計測しよ…。たしかACアダプタ200W超えてたんですよねぇ。
それでまぁ、なんだかんだ十数分くらいかかったと思いますが、結果は出ました。
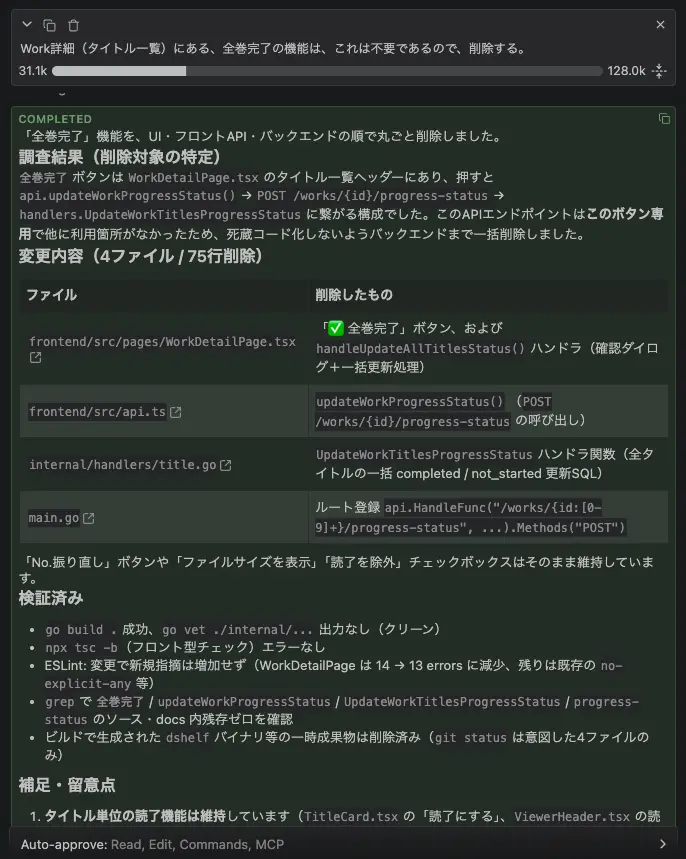
いけてそう🤔
フロントエンドだけではなく、ちゃんとバックエンドのコードも削除してデッドコード化しないようにしていますね。地味にちゃんと日本語なのも嬉しい。アップデート後はこんな感じです。
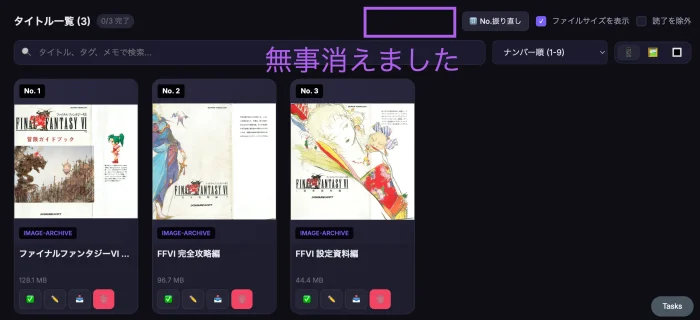
無事消えました。よろしい。
光が見えてきた
ということで、諦め気味だったローカルLLMによるコーディングは、ちょっと光が見え始めてきたなぁと感じております。あとはむしろローカルLLMでも出来るような設計と規模感でアプリケーションをまとめることのほうが重要かもしれません。
とはいえコスパの観点では微妙ですかね。LLMは間欠的になるのかなとは思うので、平均消費電力は今度改めて計測しようと思いますけれど、もし最大200Wで30分かかると0.1kWhで、これは約3円。100Wだったら1.5円くらいか。ちょっとここはちゃんと計測しないとですけど、まぁいっても数円くらいでしょう。DeepSeekだったら恐らく10-15円くらいかかる改修だったと思うので、ローカルLLMで出来る内容なら安くなる、とは言えるかなぁ。
とはいえ今はAIのせいでPC相場が狂っているので、これ目当てに買うぞ、みたいなのは全然オススメしません。経済的にはペイしないと思います。AIバブルが弾けて、ラグナロクで焼かれるべき阿呆どもが買い占めたMacやミニPC、グラボが中古で安く出回るのを待つほうがいいのではないでしょうか。ガードレールが気に入らないので、検閲緩和のモデルを使いたいんだ!というのであればいいかもですが。
まぁでも、いつか来るだろうAI企業大暴走の日に備えて、余裕があるなら用意しておくといいかもですね。AI以外にも普通に用途は幅広いので、開発者なら一台くらい高性能PCは持っておいていいかもしれません。
<関連記事>

コメント